主题
如何使用Actor模型解决并发问题?
你好,我是李玥。
对 RabbitMQ 有所了解的同学都知道,RabbitMQ 使用的开发语言是一种相对小众且“古老”的 Erlang 语言。Erlang 语言采用了一种和其他编程语言都很不一样的 Actor 模型。此外,在大数据领域被广泛使用的 Apache Flink 和 Apache Spark 也都采用了基于 Actor 模型构建的 Akka 分布式框架来实现。
我在实现一些较复杂的多线程并发场景时,尝试使用 Actor 模型,也感受到了这种编程模型的魅力。它可以更简单地解决并发编程所遇到的一系列共享资源访问冲突、时序控制和一致性的难题。
更重要的是,Actor 模型更加安全,不需要开发者有丰富的并发编程经验,就很容易写出健壮的代码。
这节课我会和你分享我对 Actor 模型的一些理解,包括:什么是 Actor 模型?它适合什么样的场景以及能解决哪些问题。此外,我们也需要了解 Actor 模型有哪些优劣势,以便我们在设计和开发过程中做出合理的选择。最后,我会和你分享一些在实际开发中使用 Actor 模型的方法和经验。
共享内存模型面临哪些挑战?
为了理解 Actor 模型,我们先来看看在不使用 Actor 模型时,如何处理多线程并发问题。
当我们使用面向对象语言开发时,一个类可以包含一些属性,通俗地说就是对象的字段,比如一个用户类,它的属性可以有用户名、手机号等等。当类实例化成一个一个对象时,每个对象的属性就保存了这个对象的状态。正是这些状态,才使得每个对象都独一无二。
按照面向对象的封装原则,对象的状态理论上不应对外暴露,但在实际开发中,很多类的属性都需要通过 getter 和 setter 方法暴露出来供外部访问。
在多线程并发场景下,有些对象需要供多个线程来并发访问,比如,一切全局的单例对象、全局的配置数据、内存中的缓存数据等等,都面临多线程并发访问的问题。
因为在运行时,每个对象和它的状态都占用特定的一块儿内存区域,所以这种我们习以为常的编程模型也被称为“共享内存模型”。
有过多线程开发经验的同学都知道,并发访问共享对象,在开发调试过程中会面临很多的挑战。
比如,并发读写的线程安全问题。
对大部分集合和复杂对象来说,读写都不是原子性的,多个线程并发访问的时候,会破坏数据的完整性。
像多个线程同时更新一个对象时,你写这一部分,我写那一部分,结果是把整个数据结构写坏了;或者,一个线程在这一点儿一点儿地读数据,另外一个线程在更新这个数据,那个读的线程读到数据可能是一部分新的,一部分旧的,读到的结果是新旧内容参半的错误数据。
再比如,竞争条件下的数据一致性问题。
在更新一个共享对象之前,通常都需要先读取对象,计算后再更新对象的某些属性。如果同时有另外一个线程也在更新这个对象,就会发生互相覆盖更新。先更新的数据被后更新的数据给覆盖掉,导致先更新的那部分内容失效。
如果这种覆盖更新并非我们所预期,那恭喜你喜提一枚 Bug。
理论上,这两个问题都可以通过锁、信号量或屏障等类似的同步机制来解决。这些同步机制本质上是将对共享内存的并行访问变成串行访问,在共享内存之前设置一道门,每次只能进入一个线程,当共享内存被占用时,其他需要访问的线程只能在门口等待。
虽然同步机制可以解决线程安全和竞争条件问题,但也带来了一系列新问题。
使用不当的同步机制可能让大多数线程在门口长时间等待,导致性能下降。某些线程或进程可能长期得不到所需的资源,导致无法执行。锁的持有和释放不当,也可能会导致各种锁冲突,活锁或死锁。
并且,因为同步机制的代价很大,实践中不可能将所有共享内存都用同步机制保护起来,那些不能保护的共享内存,仍然可能会因为线程安全或竞争条件产生各种各样的 Bug。
这些并发访问共享内存带来的问题,往往和自然时间以及执行顺序强相关。在不同的环境下会有不同的表现,各种情况组合起来分支非常多。这些特性会导致开发过程中很难都考虑周全,测试时难以覆盖各种场景,出现问题时很难复现,也几乎没办法暂停调试。我们举个例子来说明。
比如,在一个饭店服务员给顾客点餐,顾客点了一份番茄炒蛋,服务员记下后将点单送到厨房。过了十分钟,厨师做完前面的点单,准备做这个番茄炒蛋,才发现没有番茄了。服务员只能跑过去和顾客说,对不起番茄炒蛋没有了,顾客很恼火:你为什么不早说?
这个 Bug 的产生原因是访问资源前没有检查资源是否可用。
服务员修复了这个 Bug,再有顾客点番茄炒蛋时,服务员会先看一眼存放食材的冰柜,确认有足够的番茄和鸡蛋后,再帮顾客下单。
碰巧冰柜里只剩下最后一份番茄了,又碰巧两桌顾客同时点了番茄炒蛋,两个服务员同时瞄了一眼冰柜,都发现还有一份番茄,就分别给各自的顾客下单了。结果可想而知,肯定会有一桌顾客会失望。
餐厅经理又修复了这个 Bug,他规定服务员下单时,必须要在对应的食材旁边放一个“已售出”的牌子,这样就不会出现一份食材被重复出售的问题了。
然而,还有更多的 Bug,比如某天发现同一份食材上放了两个“已售出”的牌子,调查原因发现两个服务员几乎同时卖出了这份食材,他们都严格遵守了规定,在点单前都确认了这份食材没有售出,点单后放置“已售出”的牌子。这两个问题都是比较典型的竞争条件下数据一致性 Bug。
为了修复这个 Bug,餐厅给每种食材的冰柜都加了一把锁,并且每把锁都只有一把钥匙,规定只有拿到钥匙的服务员才能访问冰柜中的食材。
碰巧又有两桌同时点了番茄炒蛋,一个服务员拿了番茄冰柜的钥匙先去确认是否有番茄,另一个服务员拿了鸡蛋冰柜的钥匙去确认是否有鸡蛋,各自确认完后,就陷入了僵局,两个服务员都只能等待对方手中的钥匙。这就是典型的死锁。
类似的并发问题,我还能举出很多很多,你理解这个意思就好,限于篇幅就不再罗列了。
Actor 模型如何解决多线程并发问题?
在上面这种多线程并发场景中,使用 Actor 模型来实现同样业务逻辑,就不需要应对因并发访问内存而带来的各种问题,使我们的系统更加简单可靠。
Actor 模型的核心就是 Actor。那什么是 Actor 呢?为了便于理解,这里拿大家比较熟悉的对象来做一个类比。和对象一样,每个 Actor 拥有并维护自己的状态,但是 Actor 模型的设计原则与共享内存模型完全相反,在 Actor 模型中,Actor 不共享任何状态。
和对象不一样的是,Actor 并没有可供外部调用的函数或方法,外部与 Actor 交互的唯一方式是发消息。每个 Actor 都维护一个自己收件箱,用来接收发给这个 Actor 的消息。Actor 按照先进先出的顺序,串行处理收件箱中的每一条消息,处理消息的过程可以执行业务逻辑去修改内部状态数据,也可以给其他 Actor 发消息。
由于 Actor 没有可供外部调用的方法,所有业务逻辑都只能是由收件箱中的消息驱动,并且消息处理是串行执行的,可以理解为,每个 Actor 内所有的逻辑都是单线程串行执行的。
结合 Actor 不共享状态的特性,使得在 Actor 内部,就不存在并发的可能性,也就没有上面所说的一系列“因为并发访问共享内存”所带来的问题。
所以,在使用Actor模型来开发业务时,只需要专注于实现业务逻辑即可,完全不需要考虑并发问题。
那 Actor 模型如何解决多线程并发问题呢?接下来看一下使用 Actor 模型如何实现我们的番茄炒蛋餐厅。我们需要先定义几个 Actor:
- 顾客:负责点单、吃饭和抱怨。
- 服务员:负责为顾客点单和传菜。
- 食材管理员:负责维护食材库存状态。
- 厨师:负责制作餐品。
这里服务员和厨师都可以是多个人,食材管理员只能是一个人。服务员收到顾客点餐需求后,不用检查食材,直接给食材管理员发送点单消息,然后等待食材管理员回复消息。
食材管理员按顺序处理所有服务员发来的点单消息,先确认点单上所需食材的库存,如果没有库存,就给服务员发一条消息告知点单失败;如果库存足够,就把点单上的食材和点单一起打包成一条消息发给厨师,然后给服务员发一条消息告知点单成功。
厨师的逻辑更简单,接收食材管理员发来的消息制作餐品,餐品制作完成后将餐品打包为消息发给服务员传菜。
更详细的流程参见下面的时序图:
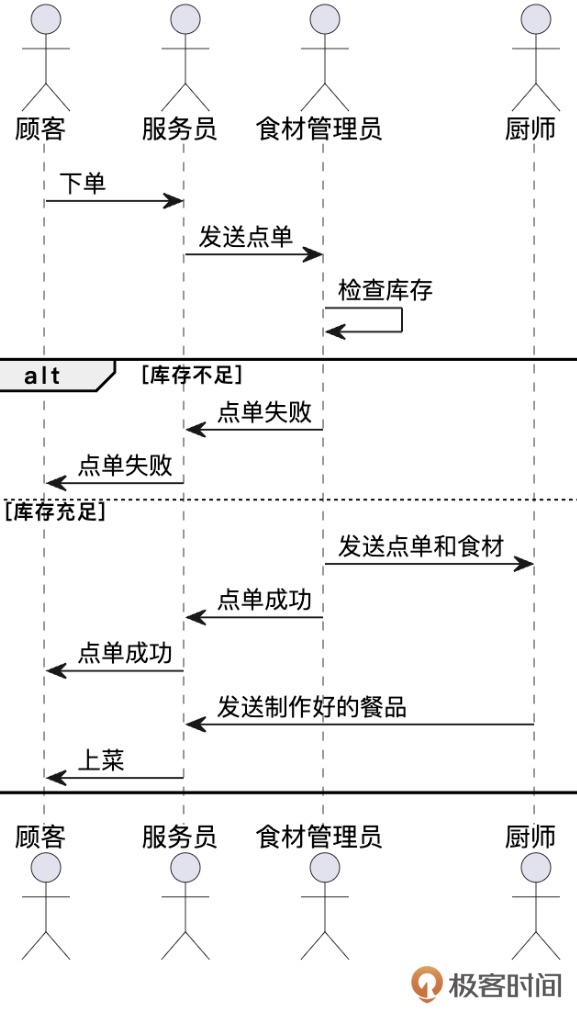
可以看到,使用 Actor 实现这个并发场景非常简单,每个 Actor 的逻辑都很简单,自然而然地就解决了棘手的共享内存并发问题。
Actor 模型的优劣势和适用场景
当然,没有一种模型是万金油,Actor 模型也有其自身的优劣势。
它的优势在于简单可靠,使用 Actor 模型开发的业务逻辑,不用考虑各种复杂的并发场景,很容易开发出安全稳定的程序,这是 Actor 模型最大的优势。
使用 Actor 模型开发时,不需要考虑并发问题,也就不需要锁。无锁的设计也会避免锁等待、锁冲突带来的性能问题,使我们更容易开发出高性能的程序。
Actor 之间通信的唯一方法是使用消息来传递信息,使得 Actor 模型很容易扩展为分布式系统。最后,在 Actor 模型下,Actor 之间的隔离性更强,也倒逼开发者设计更加松耦合的程序。
以上这些都是 Actor 模型的优势。接下来重点说一下我在使用 Actor 模型时遇到的一些问题。
Actor 模型的设计难度比较高。在现实世界的业务问题映射到 Actor 模型时,Actor 并不像面向对象设计一样那么符合人类的自然的思维模式,并且 Actor 的约束和限制比较强,需要开发者有教强的抽象能力,才能设计出合理的 Actor。
Actor 不适用于高并发场景。
我们知道,每个 Actor 都维护一个自己的收件箱,这个收件箱一般使用有界队列来实现。在高并发场景下,如果收到消息的速度超过处理消息的速度,消息就会积压在收件箱中。如果收件箱满了,就面临两难的选择:要么丢弃消息,要么阻塞等待。
如果丢弃消息,意味着 Actor 系统不再是一个可靠的消息系统,对于消息发送者,就需要考虑如果消息丢了该如何处理,这无疑极大增加了 Actor 实现的复杂度。如果阻塞等待,Actor 之间就存在时间上的事实依赖,Actor 之间可能会出现互相等待消息情况,也就是类似死锁的情况。
无论是哪种选择,都会遇到比较难解决的问题,所以最好不要让 Actor 模型系统面临超过其处理能力的高并发场景。
某些场景下,Actor 模型无法使用数据库事务来保证一致性。因为 Actor 模型不支持对外暴露函数调用,在共享内存模型下,那些可以通过本地事务来解决的数据一致性问题,在 Actor 模型下就不再适用。
举个例子,在电商订单服务中,我们可以将下单和锁定库存放在一个数据库事务中,这样可以保证订单表和库存表之间的数据一致性,避免出现超卖的情况。具体的流程如下:
开启事务
    查询库存是否满足订单要求;
    在订单表插入订单数据;
    根据订单中的商品数量,扣减相应商品的可用库存数量;
结束事务而在 Actor 模型中,订单 Actor 和库存 Actor 各自更新其内部状态的逻辑,这两段逻辑是没有办法放到一个事务中来执行的。
在 Actor 模型中,解决这类问题的方法是,设计合理的 Actor 粒度,尽量将这种事务类操作放到一个 Actor 内部。但是,面对现实中各种复杂且变化的业务需求,很难保证把所有的事务都能放在某个 Actor 内部。那些跨 Actor 的数据一致性问题,只能通过一些分布式事务的方法来解决。
使用 Actor 模型的实践经验
我们经常使用的编程语言,都没有对 Actor 模型的内置支持,不过几乎每种语言都有第三方开源的库来提供 Actor 模型所需的功能,比如 Java 中的 Akka 等。
但这些第三方库因为缺少编程语言的内部支持,难以在编译过程中对违反 Actor 模型约束的代码给出错误提示,所以只能依靠开发者来确保代码遵循 Actor 模型的约束。
以下是几种容易违反约束的常见情况。
首先,Actor 的所有逻辑都必须是由收件箱的消息来驱动执行,绝对不能有例外。对于一些需要定时执行的逻辑,需要 Actor 外部的定时器 Actor 来触发,触发的方法也必须遵循 Actor 模型,也就是给 Actor 发一条消息。
在 Actor 内部的执行逻辑中,尽量不要有阻塞线程等待的逻辑,这会阻塞整个 Actor。对于需要 Sleep 一段时间的场景,可以给外部定时器 Actor 发消息,让定时器在所需等待时间到达时,再给自己发一条消息来触发执行后续的逻辑。对于需要长时间等待的同步调用方法,尽量改成异步调用的方式,避免等待。
在 Actor 发送消息的时候,要注意不要把内部状态的引用通过消息共享到外部。很多场景下,我们需要把内部状态的一部分数据作为消息发给其他 Actor,这时要特别注意发送的是“引用”还是“数据”。
在很多语言中,变量实际上指向内存的一个指针,有些语言称为“引用”。如果将指向内部状态的引用通过消息发送给其他 Actor,那其他 Actor 就可以通过这个引用访问到这个 Actor 的内部状态,而这个内部状态是不应该对外暴露的。
一旦暴露出去,我们的系统其实就变成了共享内存模型,那所有共享内存模型所面临的并发问题所引发的 Bug 都会随之而来。
正确的做法是将需要发送的内部状态数据做一份深拷贝,将拷贝的副本作为消息发送出去。
小结
面对复杂的并发场景时,使用共享内存模型来开发是一件很有挑战的任务,需要开发人员具备相关的技术知识,有丰富的经验,并且足够严谨认真,才能有可能开发出安全稳定的系统。
而使用 Actor 模型来应对复杂的并发场景时,开发者无需考虑并发问题,很容易开发出安全稳定的程序。无锁、高性能和松耦合都是 Actor 模型的优点。但 Actor 模型的设计难度较高,难以应对高并发场景,对事务场景的兼容性欠佳,这些也限制了 Actor 模型的使用范围。
使用 Actor 模型需要引入第三方的 Actor 库来实现对 Actor 功能的支持,开发者需要遵循 Actor 模型的约束,保证 Actor 内所有的逻辑都必须由消息驱动执行,逻辑执行过程中尽量避免阻塞等待。Actor 发送消息的时候,要小心不要把内部状态的引用通过消息共享到外部。
最后,再总结一下 Actor 模型的几个关键原则:
- Actor 从不暴露内部状态。
- Actor 只通过消息与外部交互。
- Actor 的所有内部逻辑都是由消息驱动,单线程串行执行。
我自己也用 Java 实现了一套轻量级的 Actor 模型库,之前主要用于我开发的系统中。这里也开源并分享出来,项目中也包含了这篇文章中提到的番茄炒蛋餐厅例子的实现示例代码,你可以用来学习理解 Actor 模型,也可以尝试使用它。项目的地址是:点这里。
思考题
实践中大部分系统仍然是请求/响应这种同步的调用方式,我们在系统的某个局部使用 Actor 模型时,就需要考虑如何将 Actor 这种异步模型适配到同步请求/响应模型上来。
比如在番茄炒蛋餐厅中,所有的员工都变成了异步的 Actor,而顾客还是习惯于同步方式与服务员交互,所以服务员必须给顾客提供同步下单接口:
class Waiter {
    public boolean placeOrder(Map<String /* 菜品 */, Integer/* 数量 */> order) {
        // 给食材管理员发消息下单
        // 告知顾客是否下单成功
    }
}你可以尝试使用任何一种语言实现这个方法,主要考虑如何在同步调用中适配 Actor 异步模型。
欢迎你在评论区留言,我们下节课再见!
上节课思考题答案
关于上节课我提到的问题,参考答案如下:
Q:这种重排序的方法存在哪些限制,或者说在什么情况下这种方法就不适用了?
A:这种重排序方法依赖的是对缓存的一定时间窗口范围内的消息重排序,如果消息乱序的时间范围过大,超过了缓存时间窗口,那就无法实现保序了。
Q:在实现重排序时,有哪些异常情况需要考虑,如何处理这些异常情况?
A:在实现重排序时,要对重排序的缓冲区设置合理的大小,和缓存消息 ID 判断重复消息的方法类似,这里就不再重复了。
此外,需要设置一个最大等待时长,以防期望的下一条消息一直不到。超过等待时长,就要果断跳过这条消息继续处理下一条,否则会出现因为一条消息丢失而卡住整个消息处理流程的问题。
在实际生产环境中,还要添加相应的告警和监控,监控重排序缓冲区内消息数量,监控并记录跳过的消息序号,以便后续做补偿处理。