主题
31-CQRS(上):实现查询功能有什么诀窍?
你好,我是钟敬。
前面几节课我们讲完了限界上下文。接下来的两节课,我们将学习一个和查询功能相关的模式——CQRS。虽然 《领域驱动设计》原书里没有这个模式,但近年来,CQRS 常常和 DDD 结合使用。
不过也有人对 CQRS有不同意见。这是因为,CQRS 实际上也有不同的变化,这就造成了不同的人对 CQRS 的理解也不太一样。学完这两节课,我想你就知道怎么分辨了。
CQRS 是 Command Query Responsibility Segregation 的简称,中文是 “命令查询职责分离”。这个名字乍听起来也不太好理解,咱们还是从业务需求开始,一步一步地理解。
查询功能遇到的问题
在第三个迭代中,在工时管理上下文,增加了更多的查询和统计需求。
我们先看一个简单的需求,给定一个工时项,要求查询出这个工时项下的所有工时记录,并显示在屏幕上。要求每条返回记录的字段包括“员工号”“员工姓名”“日期”“工时”和“备注”,并根据员工号和日期升序排序。为了简化问题,我们先不考虑“不在本级报工时”以及“父子工时项”的问题。
我们回忆一下工时项管理的领域模型。
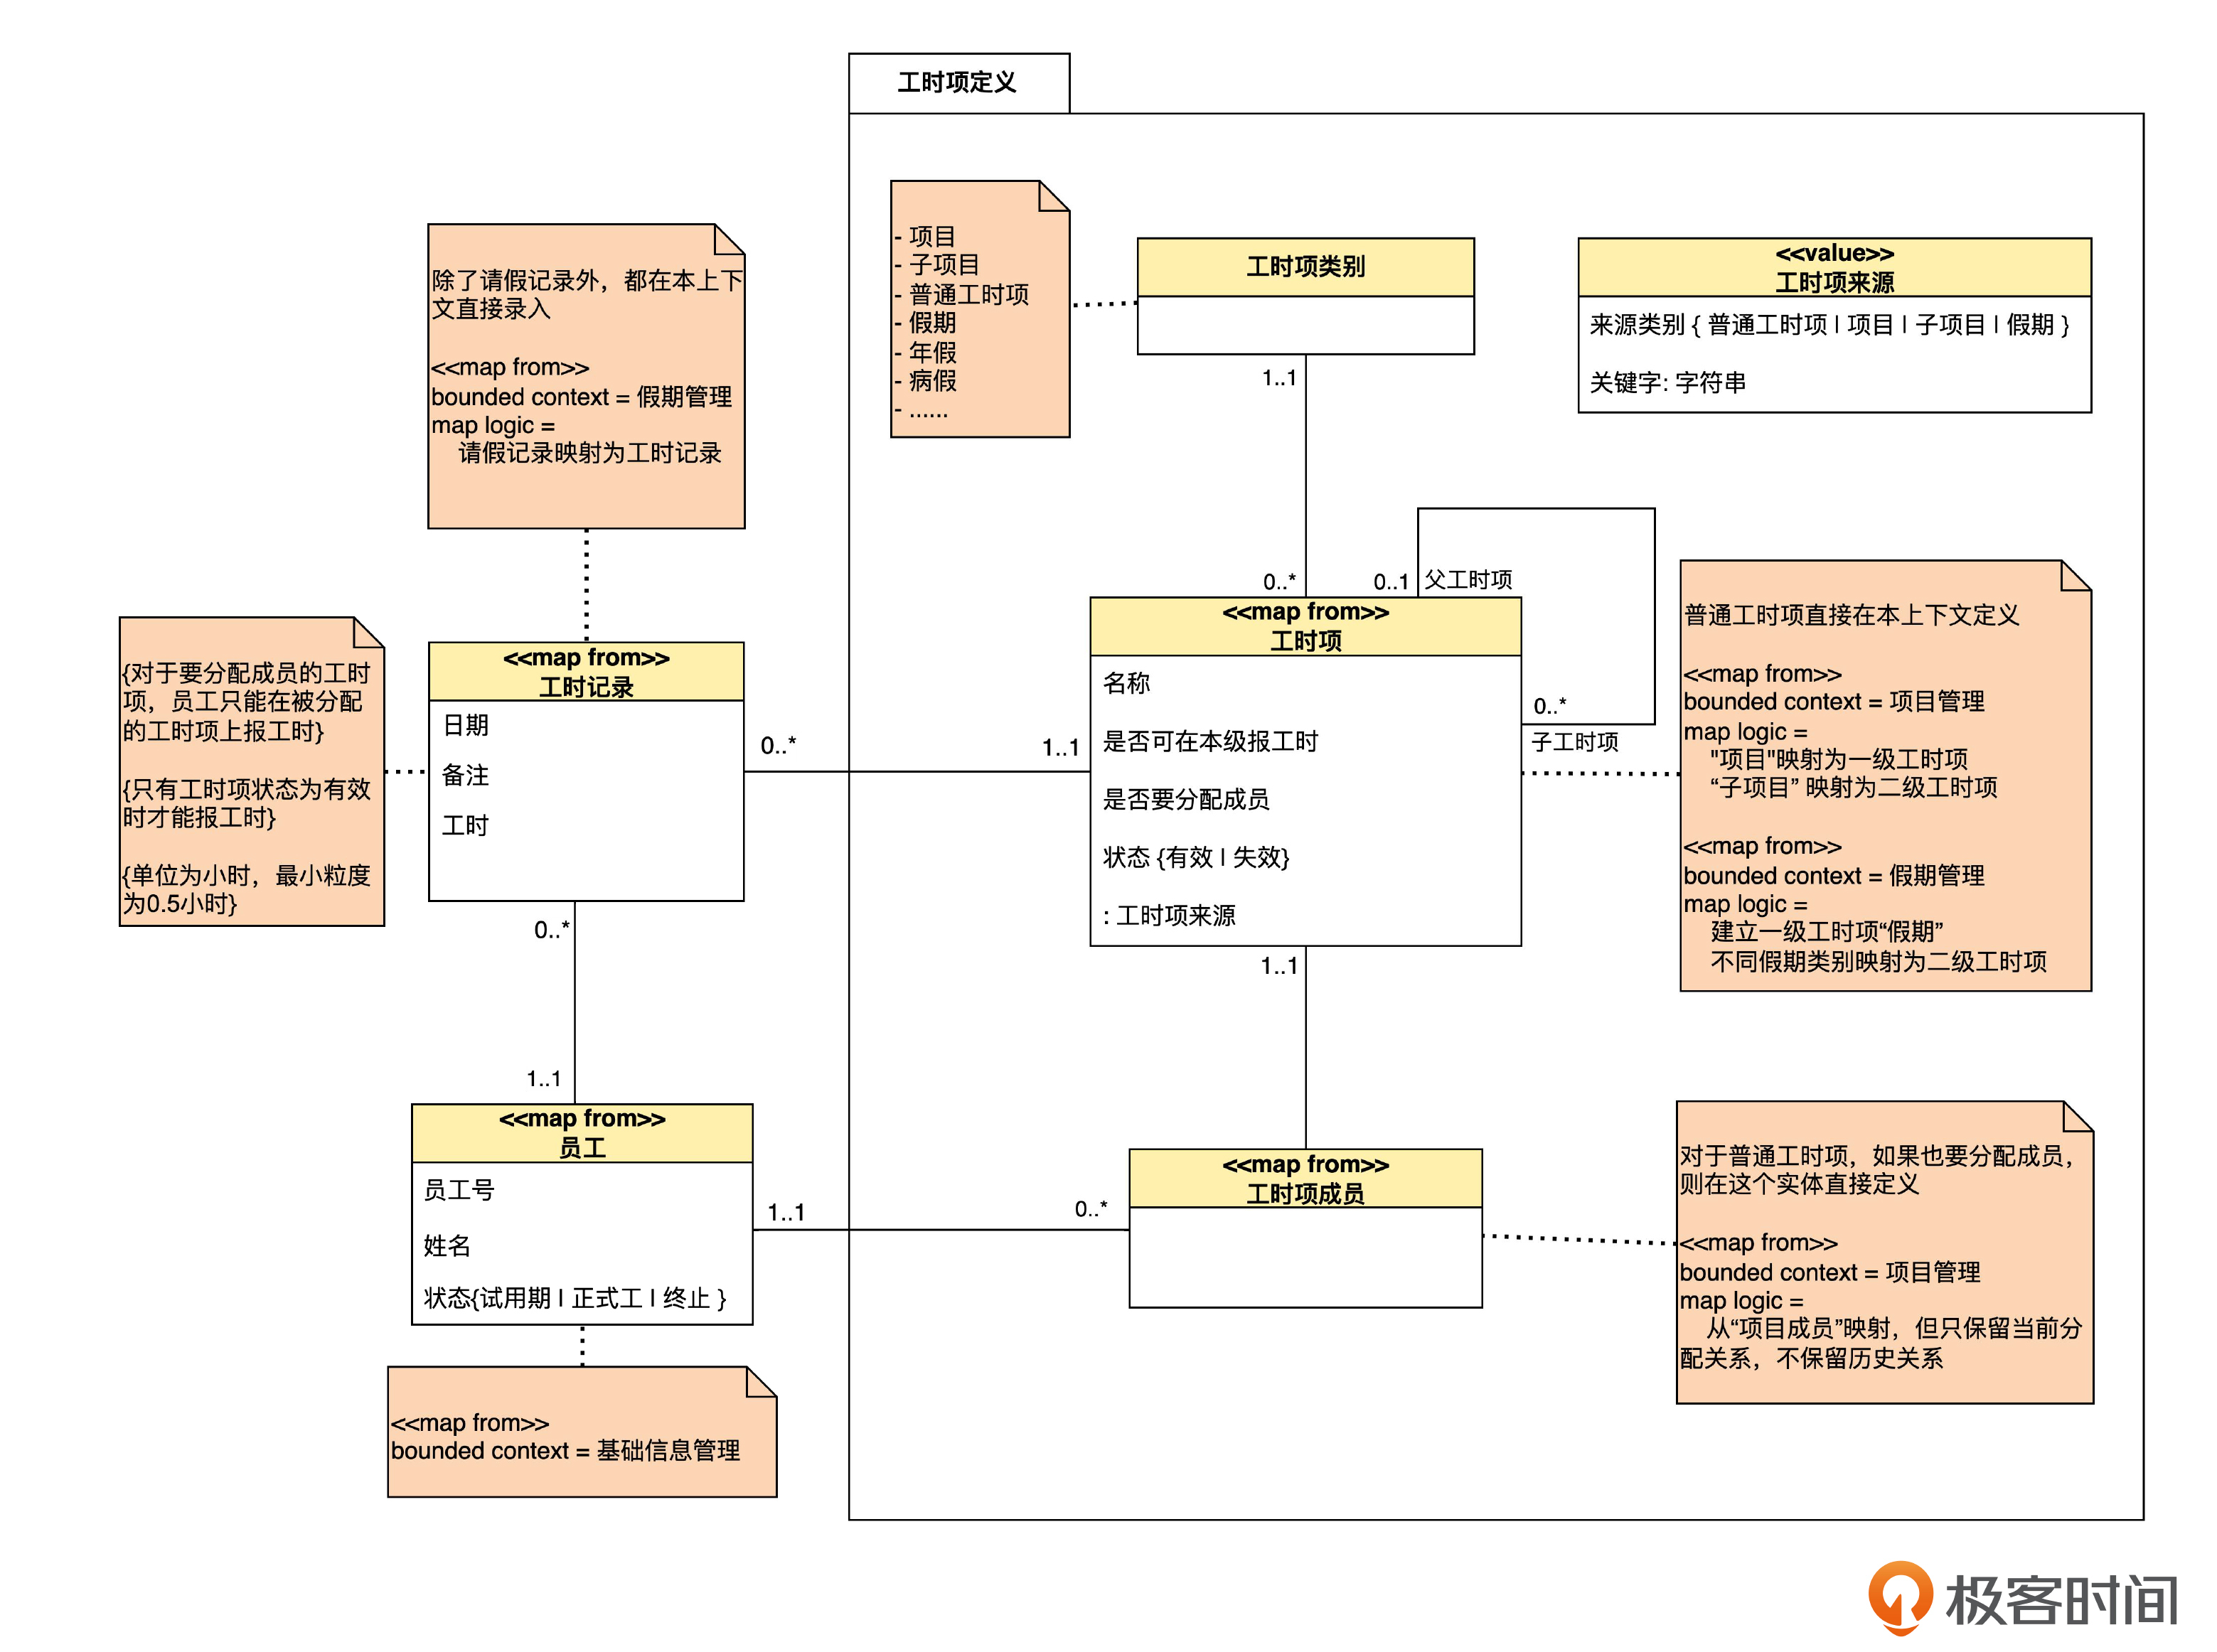
根据之前学习的数据库设计以及上下文映射的方法,假定我们选择的是在本地建立员工表,并从“基础信息管理”上下文映射员工信息的策略。那么本地数据库会有员工(emp)表和工时记录(effort_record)表。
在没有学习DDD之前,其实这个需求很简单,只要一条SQL语句就可以搞定了。大概是后面这样。
sql
select em.num, em.name, er.work_date, er.effort, er.notes
from effort_record as er
  left join emp as em
    on er.emp_id = em.id
       and er.tenant_id = em.tenant_id
where er.tenant_id = ?
  and er.effort_item_id = ?
order by em.num, er.work_date;这个查询是把 effort_record(工时记录表)和 emp(员工)表做了一个表连接,然后根据 effort_item_id (工时项ID)查出相应的数据。
但是,现在学了 DDD,再要实现这个功能,你可能会觉得反而更麻烦了。因为这时候要经过领域模型得到这个查询结果。我把设计层面的类图画出来,来辅助我们的思考。
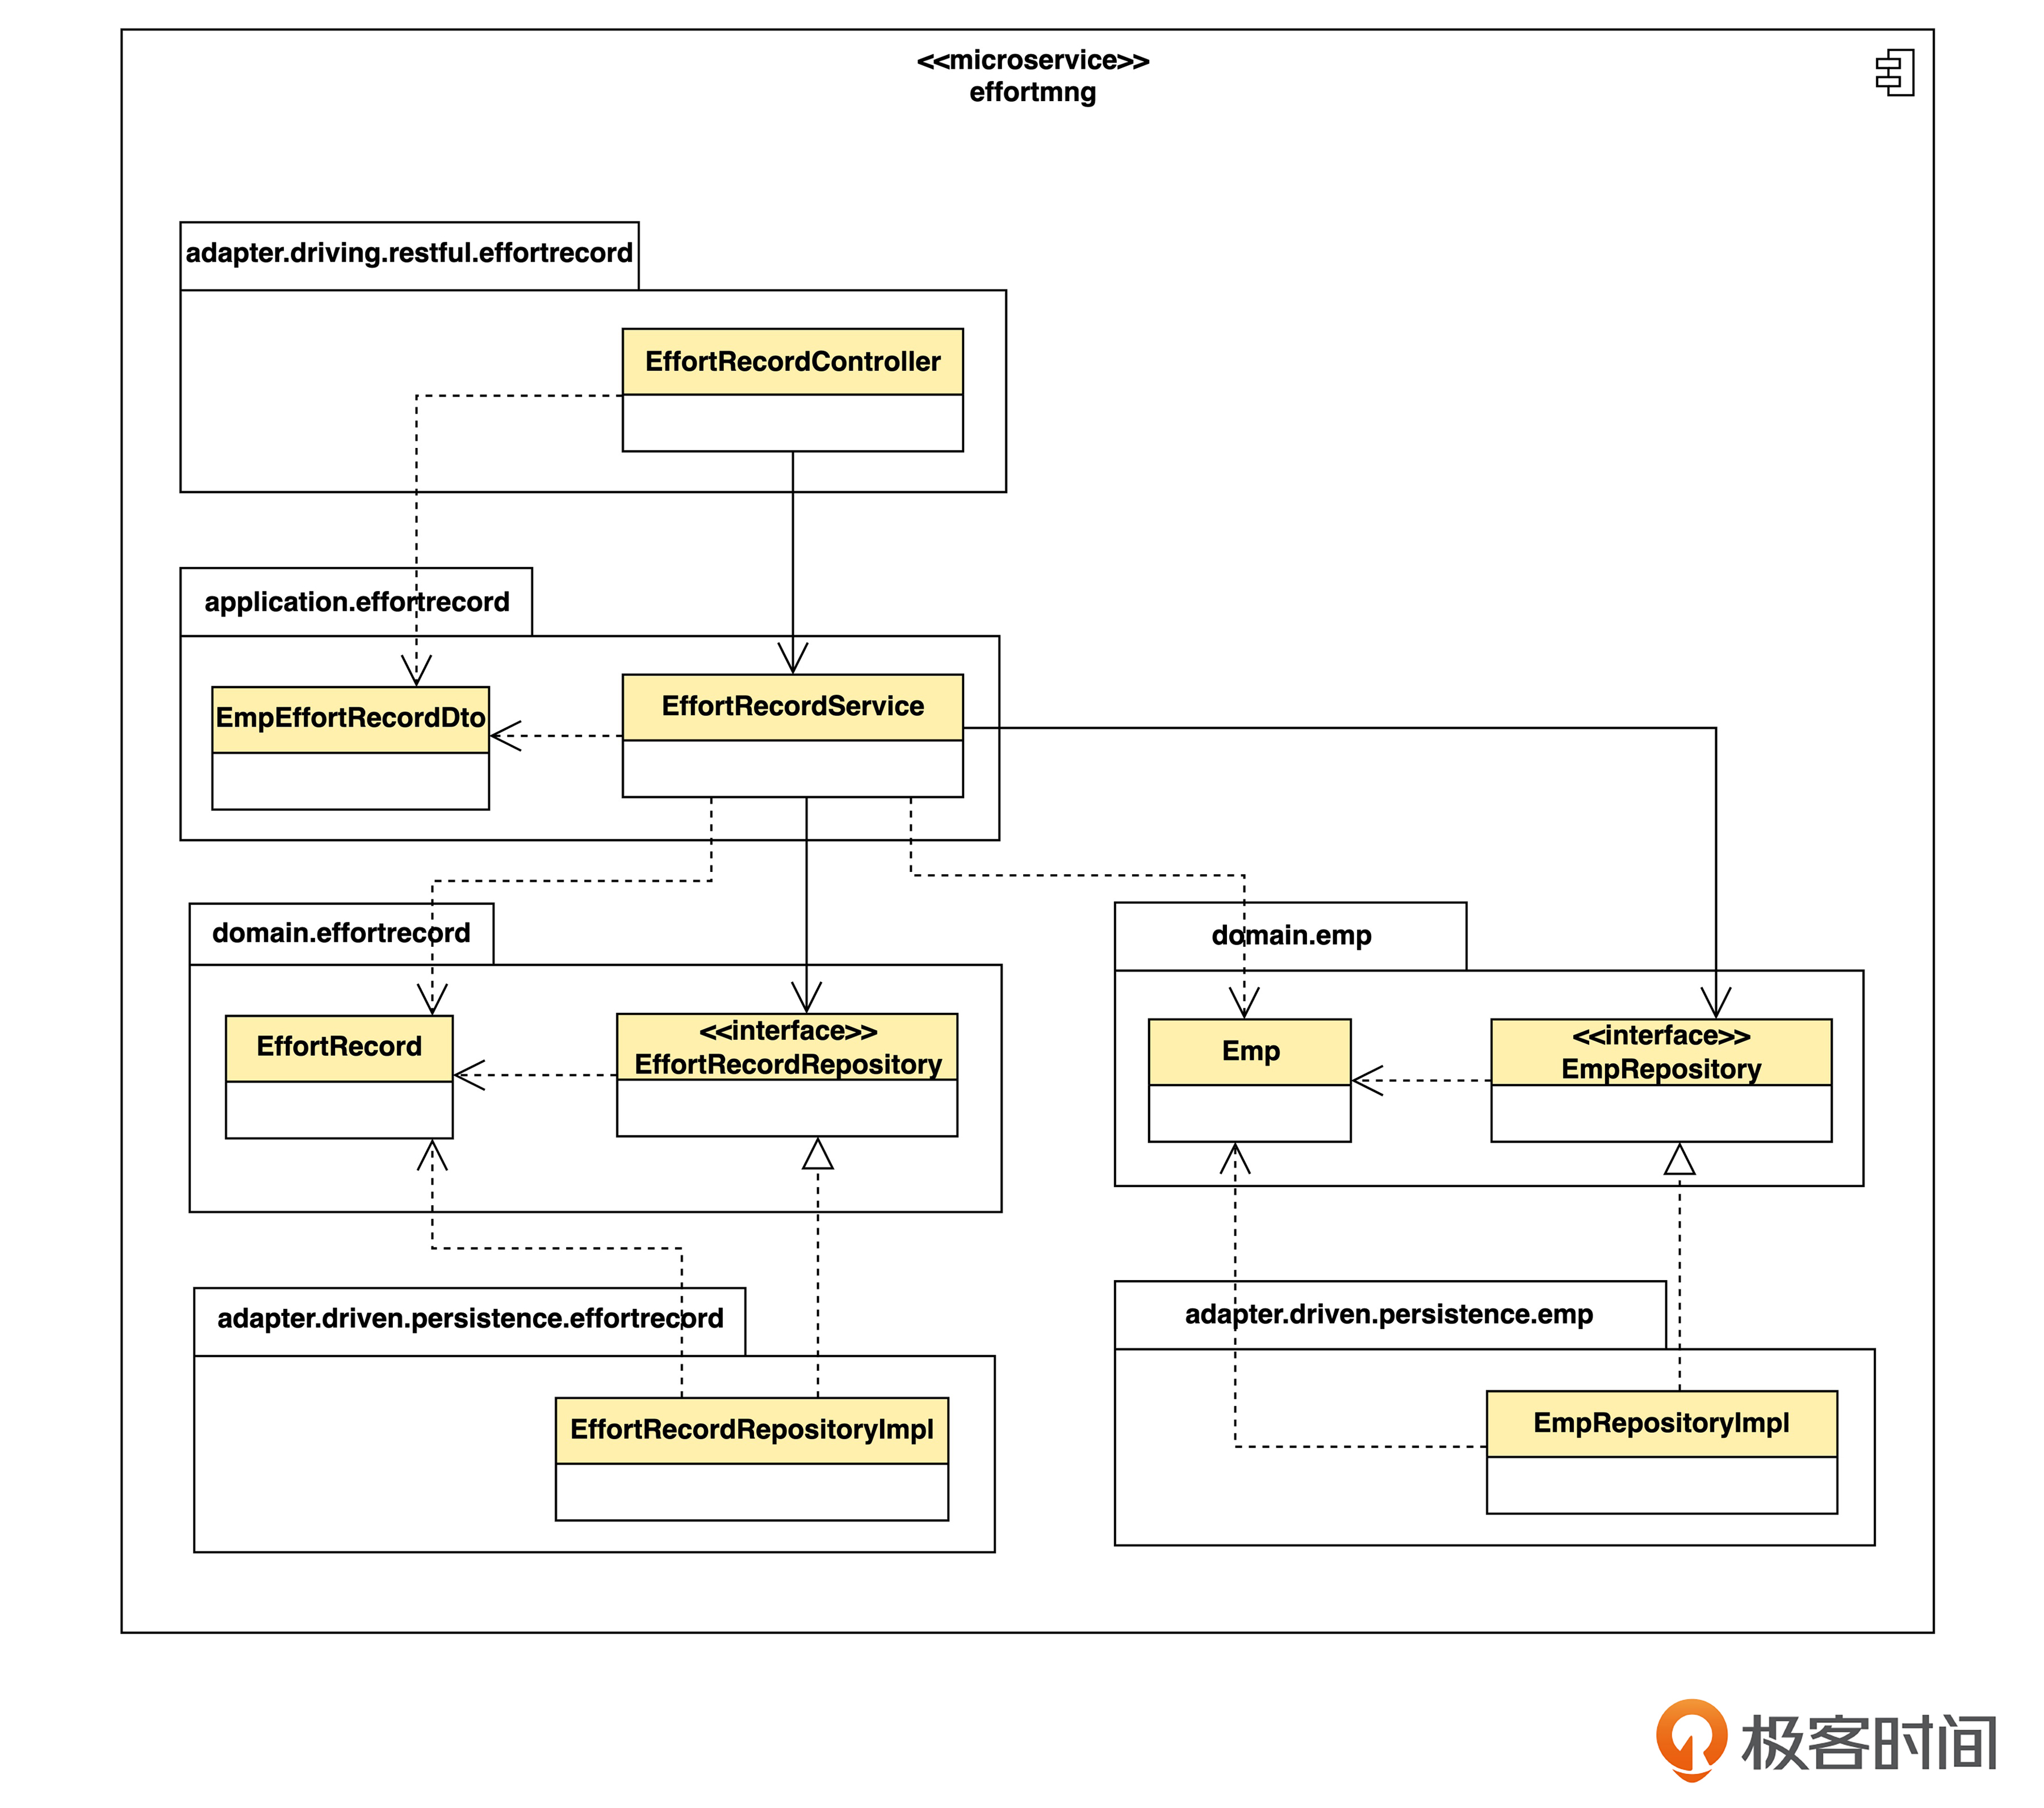
我们从 EffortRecordService(也就是工时记录服务)开始看。这个服务中的方法会接收一个EffortItemID(工时项ID),最后返回一个含有所需数据的列表。每一条数据记录封装在名为 EmpEffortRecordDto 的DTO里。
具体包括三步。
第一步,工时记录服务会调用 EffortRecordRepository,根据工时项ID取得一堆 EffortRecord (工时记录)实体。
第二步,再根据每个工时记录实体中的员工ID,调用 EmpRepository ,为每个工时记录取得相应的员工实体。这里要注意避免对同一个员工实体重复查询数据库。
第三步,把所有工时记录和对应的员工实体信息拼成相应的 EmpEffortRecordDto ,排序后组装成列表返回。
顺便说一下,我在这里没有贴代码,而是给出了设计图。这个图和代码其实是一一对应的。希望你能够多练一下看着图写出代码、看着代码反推出图的技巧。
上面的做法确实符合我们之前说的“代码和模型一致”这个要求,但是你可能已经发现这么做会带来的问题了。
- 程序编写比较麻烦,原来一句 SQL 就可以解决的问题,现在要分几步实现。
- 这样的程序可能带来性能问题。
那么该怎么解决呢?这里的核心问题是,查询功能是否必须经过领域模型呢?
要回答这个问题,我们首先要考虑一下为什么之前的逻辑要经过领域模型。其中一个主要原因是,如果绕过领域模型,领域逻辑和数据就可能分散在程序各个地方,无法保证数据的完整和一致性,程序也将很难理解和维护。对于增、删、改这样的逻辑,这样的原因确实说得通。但是,查询的逻辑并不会改变数据,所以并不会造成数据的不完整和不一致。
事实上,前人已经意识到了查询和其他功能的不同之处,主张采用不同的方式来处理查询逻辑,并提出了所谓 CQRS 架构。
最早提出这个说法的是 Greg Young。他把增、删、改功能称为 Command(命令),把查询称为 Query,这两种功能的职责不同,应该采用不同的方式来处理,因此叫做“命令查询职责分离”(Command Query Responsibility Segregation ),简称 CQRS。我们可以先粗放一点来理解,一共是两条规则。
第一,命令要走领域模型。
第二,查询不走领域模型,直接用 SQL 和 DTO。
后来,业界对 CQRS 又形成了一些不太一样的理解。这是因为,CQRS 其实可从几个不同的层面来考虑,我们分别来看看。
代码结构分离
第一个层面是代码结构的分离。为了说明这个问题,咱们先看图。
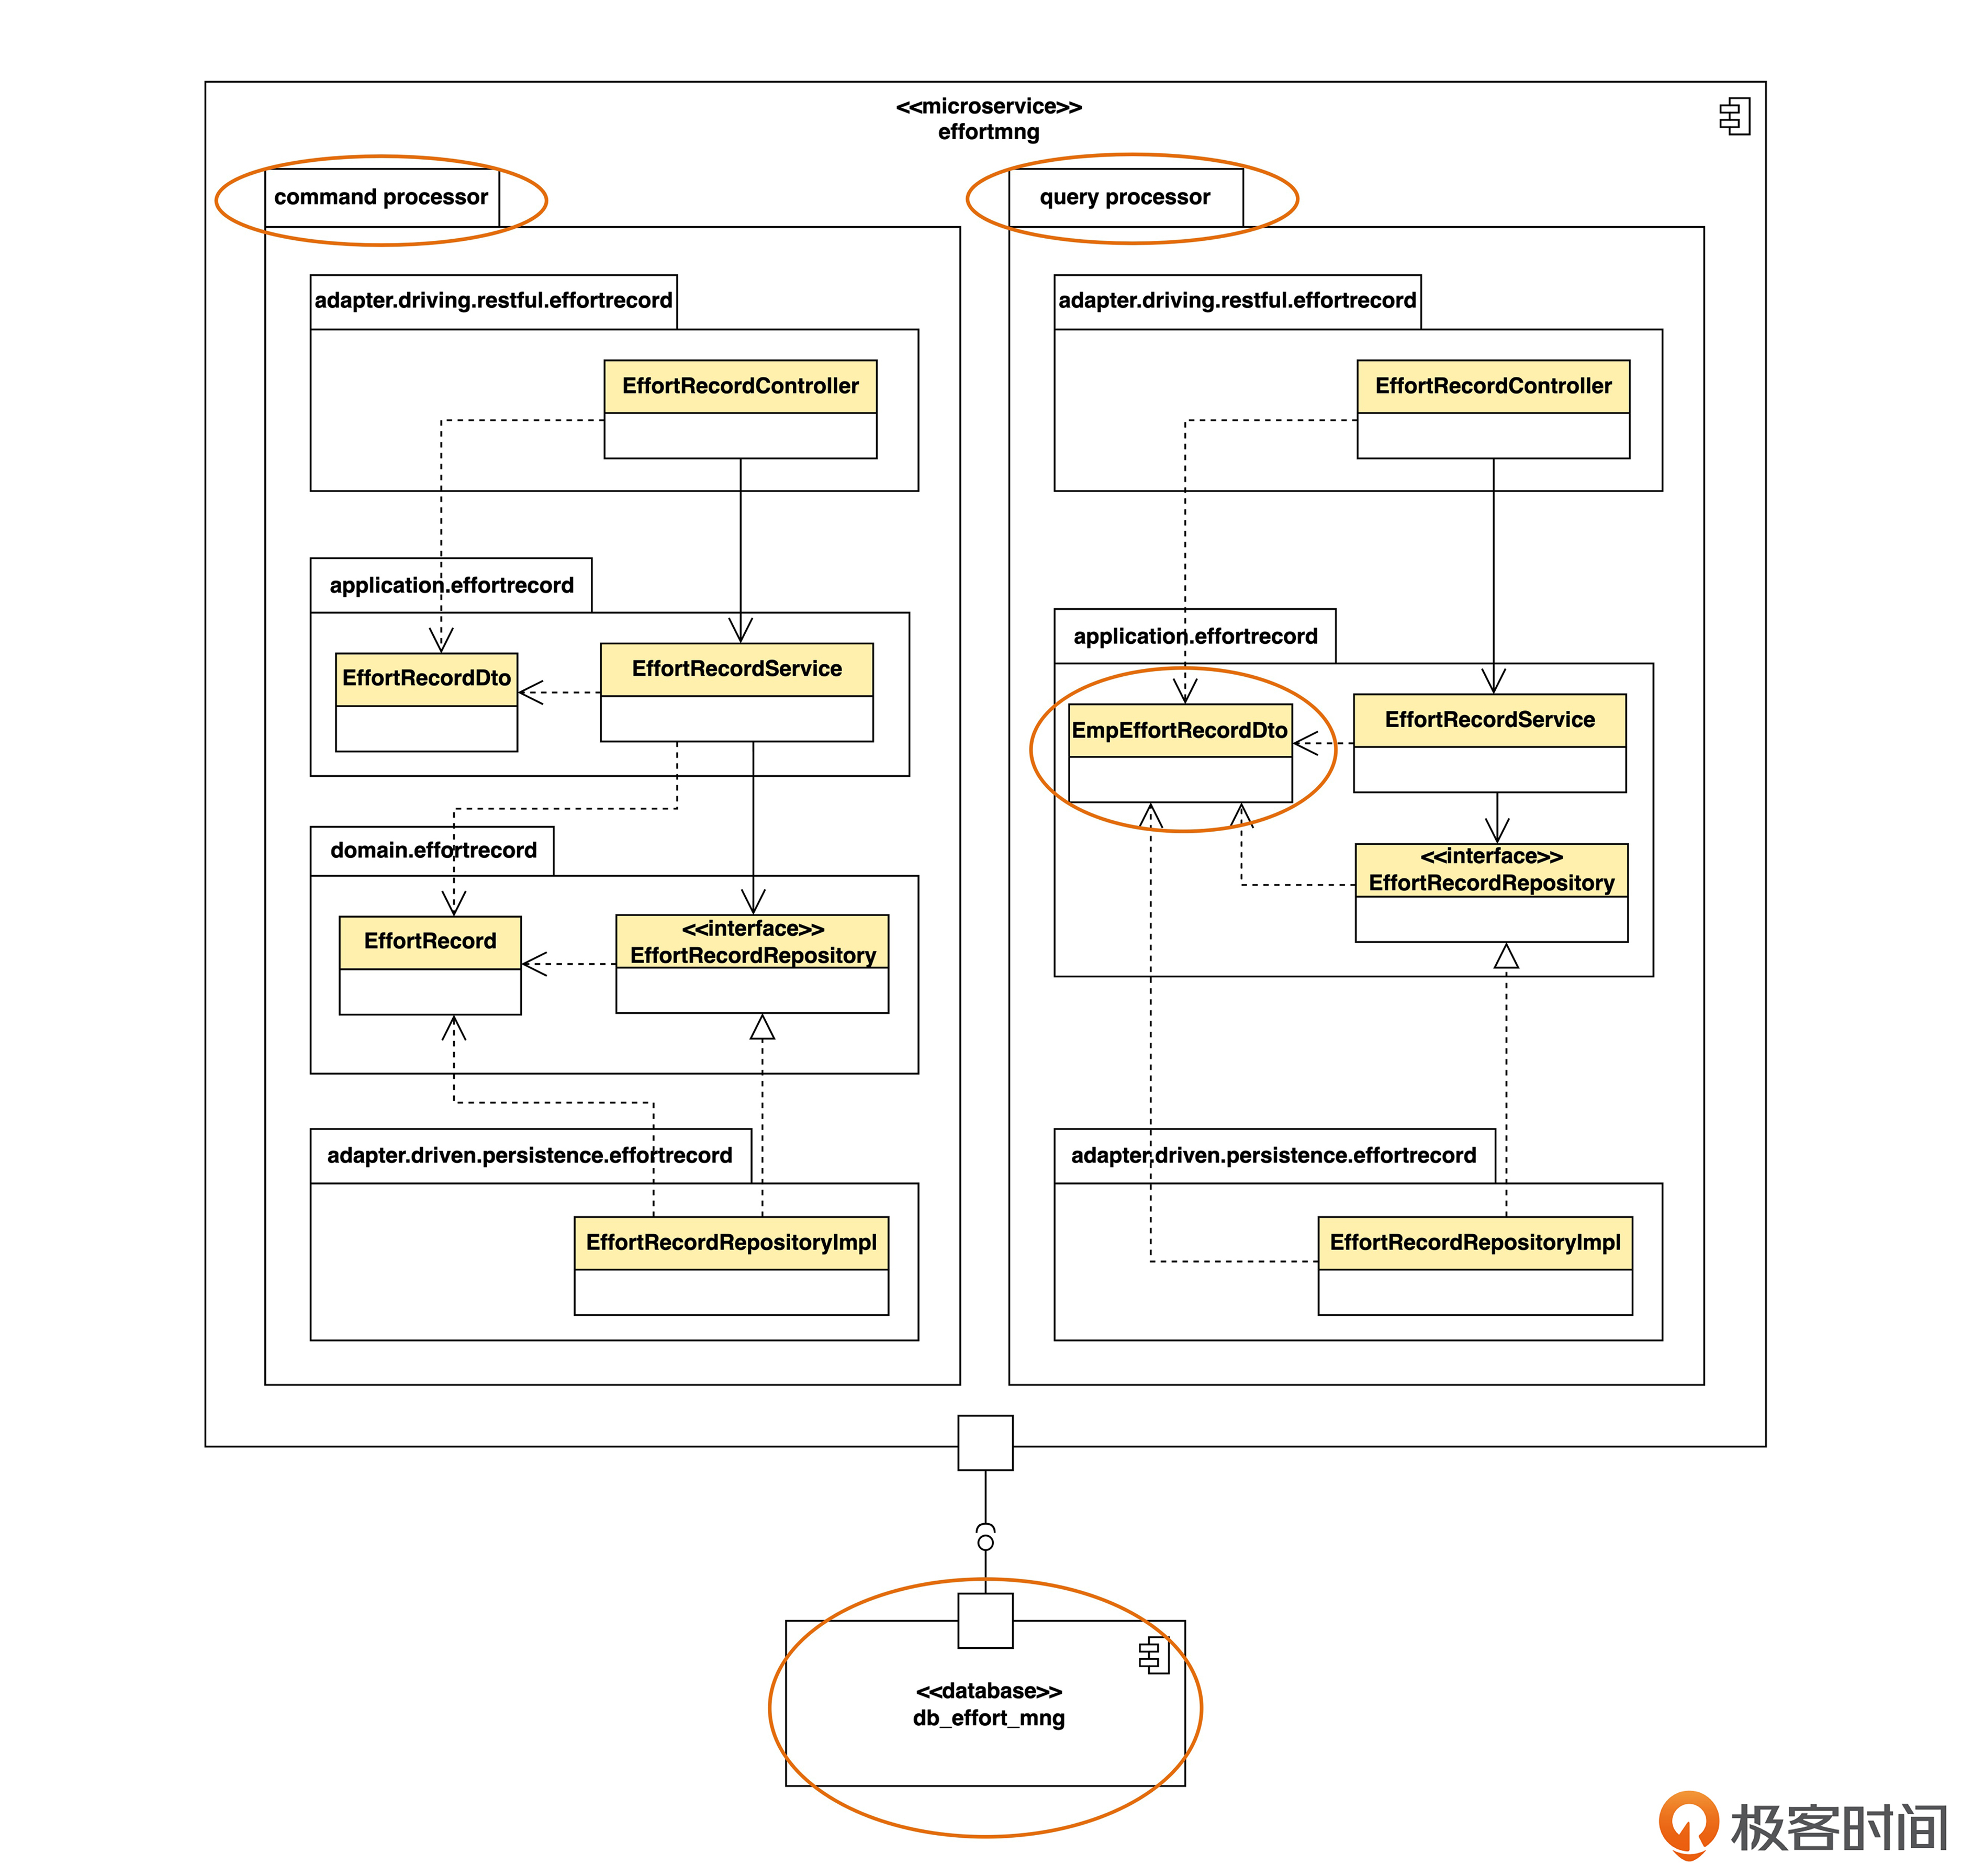
在这个图里,代码首先分成了两个包,一个是 command processor(命令处理器),另一个是 query processor(查询处理器)。其中,命令处理器采用的就是之前基于领域模型的分层架构。
关键看查询处理器,你会发现里面根本就没有领域层了,当然也就没有领域对象了。这里直接用 EmpEffortRecordDto 来表示数据。应用服务调用仓库,仓库里用 SQL 语句进行连表查询,得到的数据直接填到 DTO 里。应用服务可能还要对DTO再做少许加工,就可以直接返回了。
由于 EmpEffortRecordDto 表示的是要查询的数据的结构,所以,也有人把由这些对象组成的模型称为“查询模型”(query model)或者“读模型”(read model)。在命名上,如果简洁一些,也可以不用 Dto 这个后缀。
最后,在图里我们把数据库也看做组件,用组件图来表示,它对外暴露的接口就是 SQL。
这种代码结构的分离,是最简单的 CQRS,多数采用了 DDD 分层架构的程序都可以尝试使用。
除了这种最简单的用法,我们再来看看其他几种策略,它们在带来收益的同时,也会有比较明显的代价,这时我们就要多权衡一下了。
数据库结构分离
前面程序里的 SQL 用了连表查询,有时候会造成性能问题。
本质原因是,程序里的查询模型和数据库里的表架构不一致。这是因为,数据库里的表结构,或者说物理数据模型,是根据领域模型,而不是查询模型设计的。从物理数据模型到程序中的查询模型的转换,是通过 SQL完成的。而这种转换需要表连接,就可能造成性能问题。
那怎么解决这种性能问题呢?
一种解决思路是为查询单独创建一套表,其中采用“反规范化设计”,也就是引入冗余字段,使表结构和查询模型吻合,从而避免或减少表连接。
我画出了这种设计的架构图,供你参考。
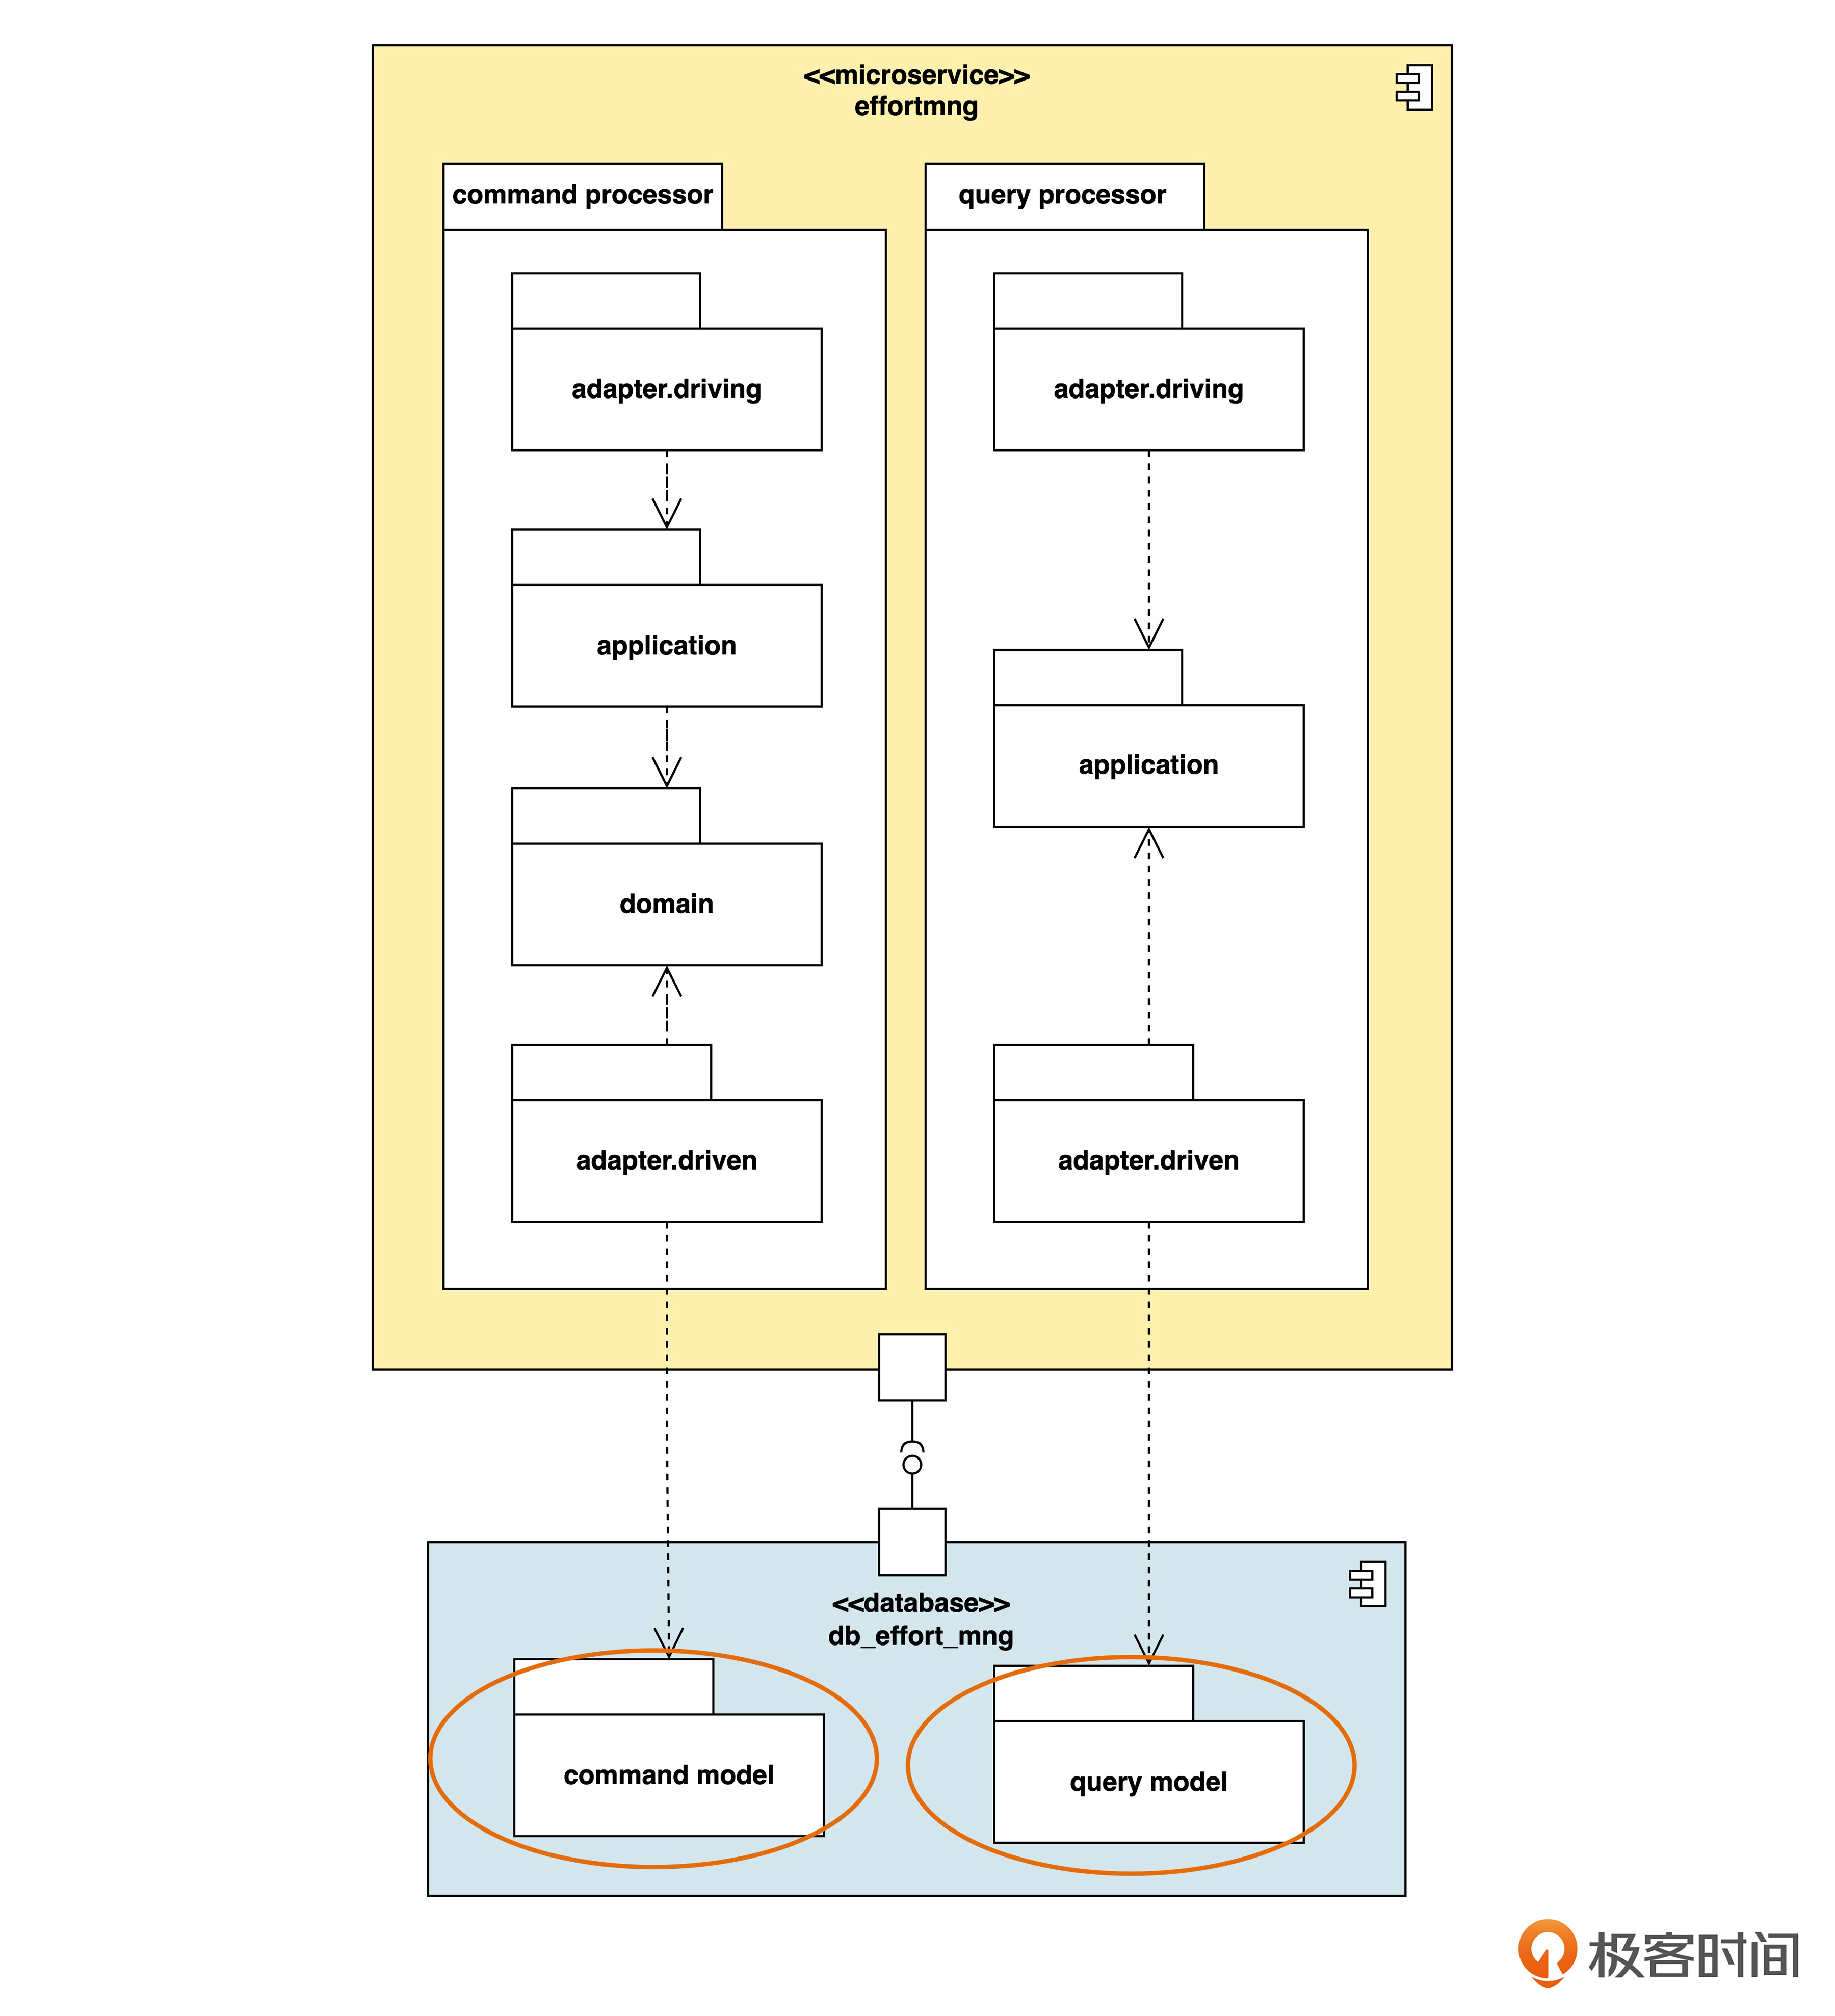
由于包内部的结构是类似的,所以这张图忽略了内部细节,只包含外层的包结构。
数据库里的表分成了两套——命令模型(command model)和查询模型(query model),分别由命令处理器和查询处理器访问。其中命令模型中的表是根据领域模型设计的,查询模型部分的表就是根据查询需求进行了反规范化设计。
命令处理器对命令模型里的表进行操作后,要把数据同步给查询模型。有多种同步方案可供选择,比如说,命令模型中的仓库,同时写两边的数据表,或者使用触发器,还可以用同步或异步的事件驱动机制。
反规范化设计
为了实现数据库结构分离,需要进行反规范化设计。为了帮你深入了解这一点,我给你
举例说明一下反规范化的表结构设计。
命令模型里的工时记录表是后面这样。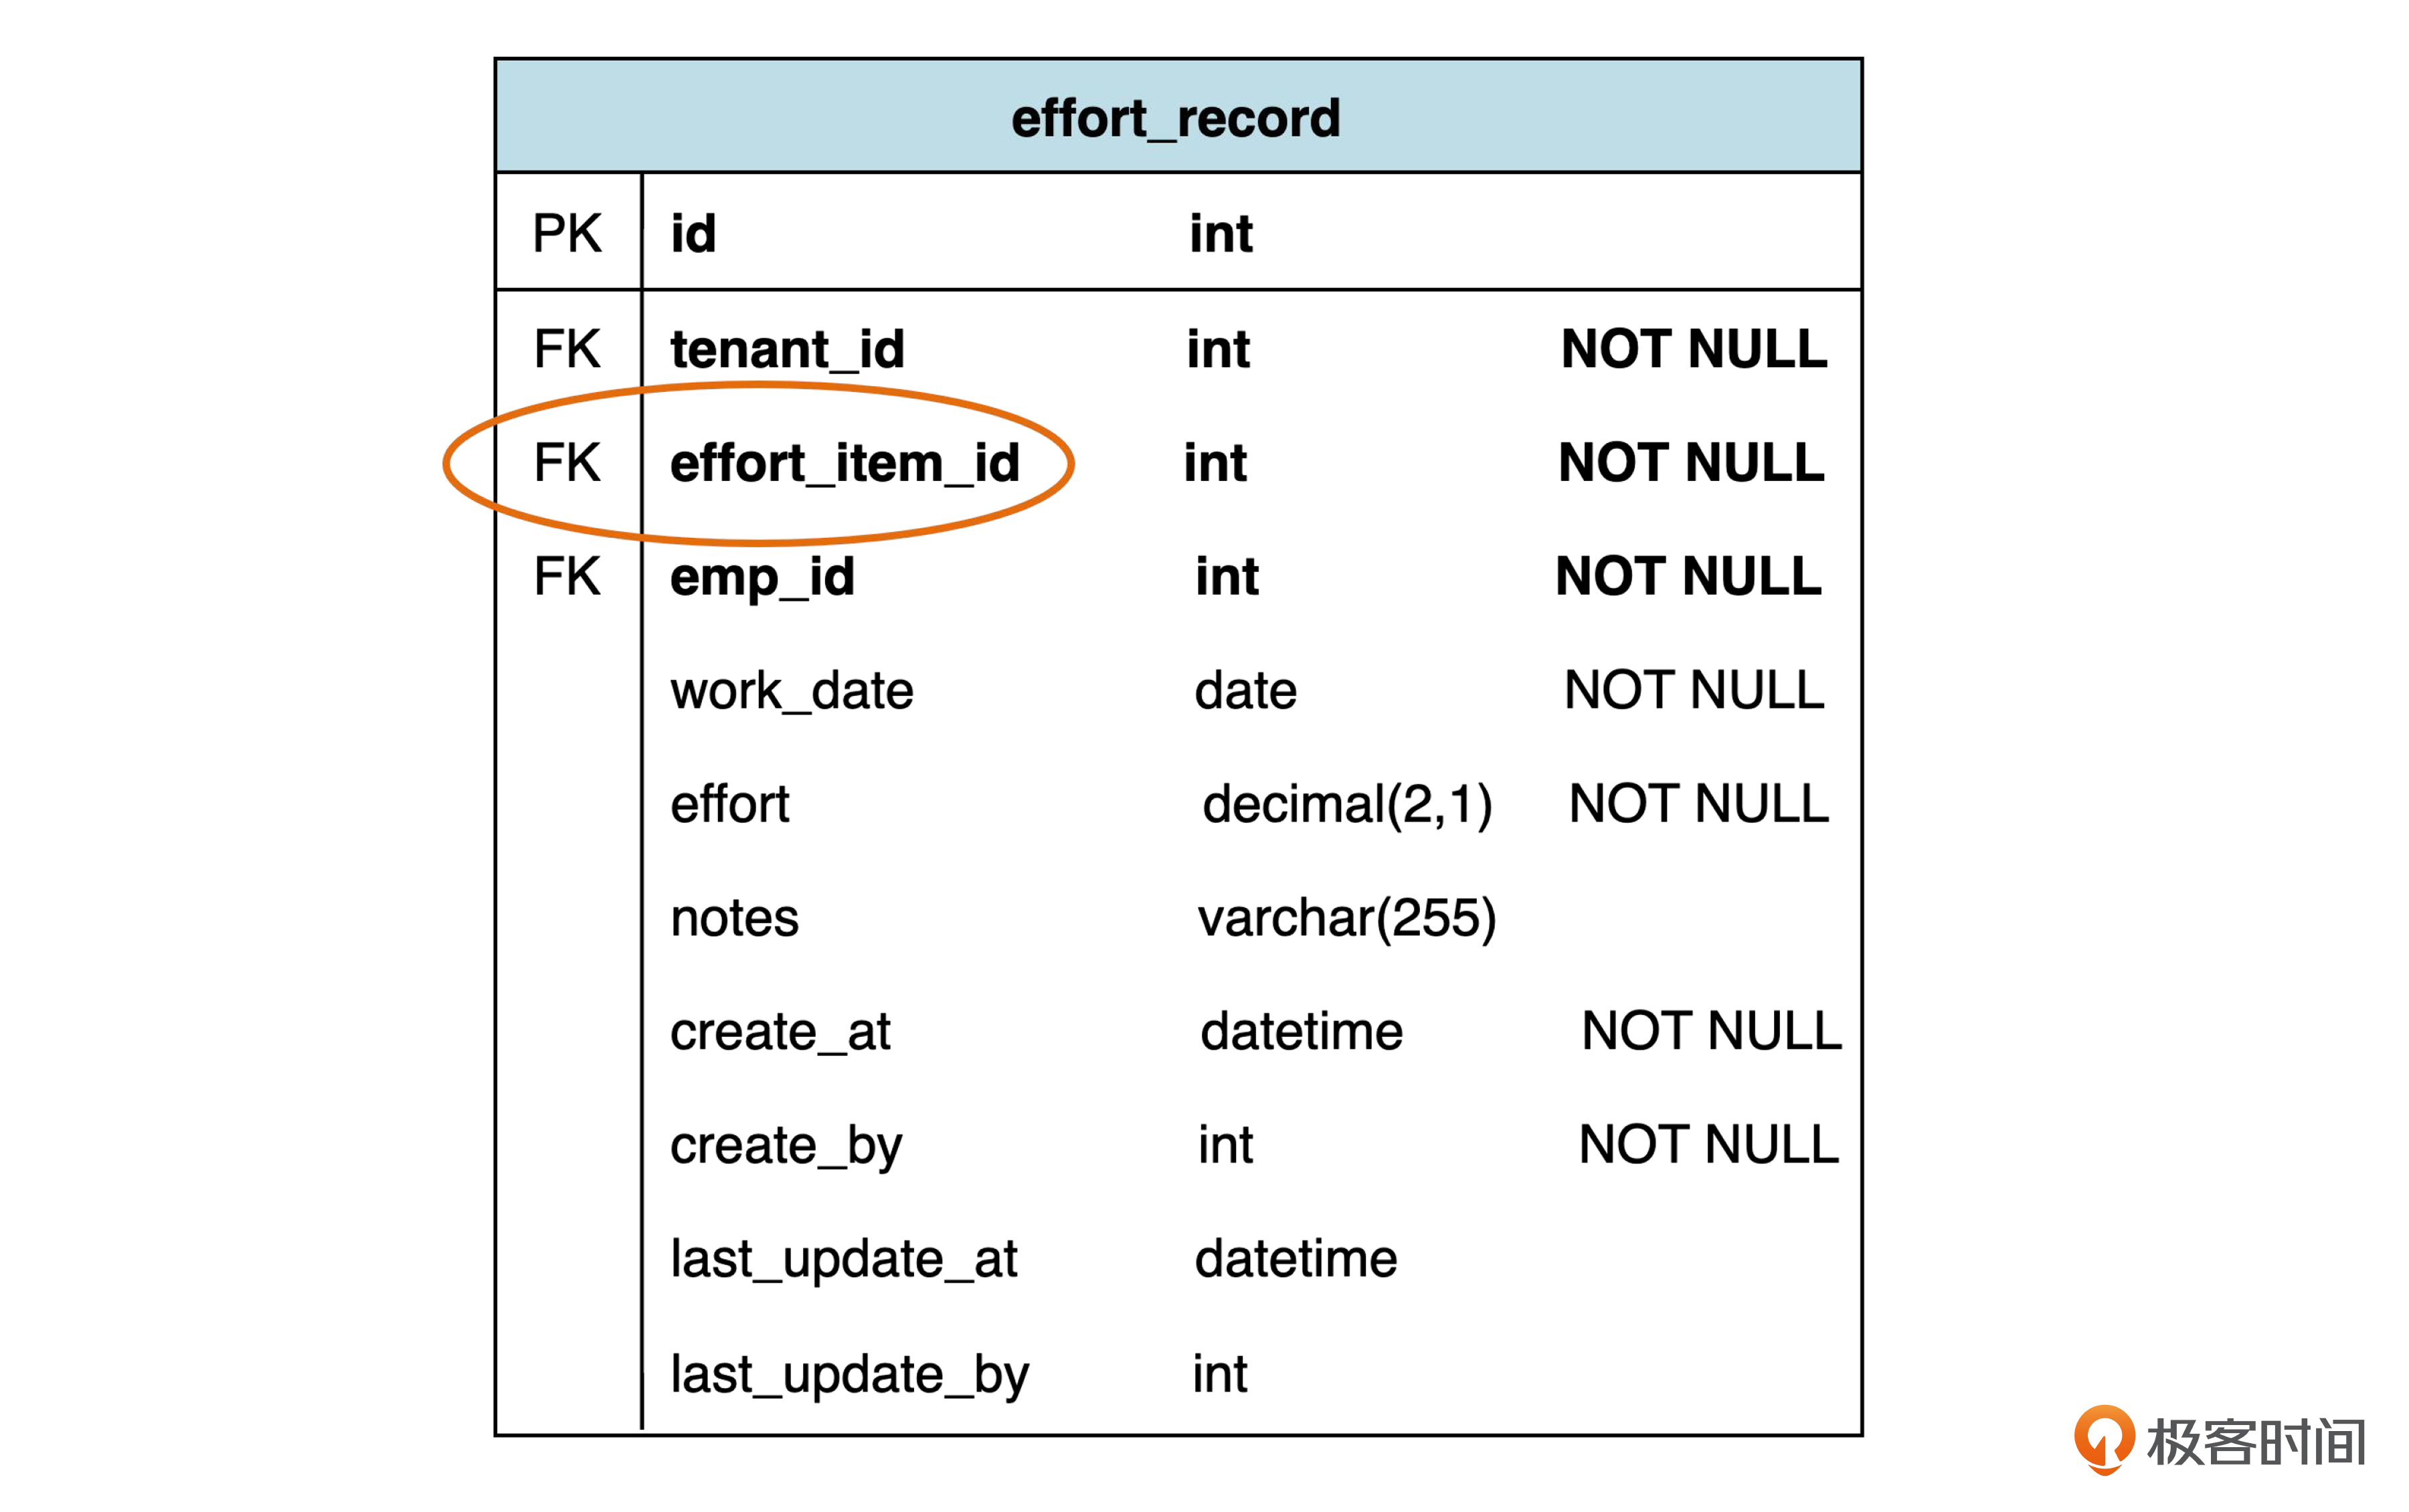
这个表我们在迭代一见过类似的,现在唯一的不同是原来的 project_id (项目ID)换成了现在的 effort_item_id(工时项ID)。这是因为最初的需求只是为项目报工时,而现在要为更广义的工时项报工时了。
查询模型里的员工工时记录表是后面这样。
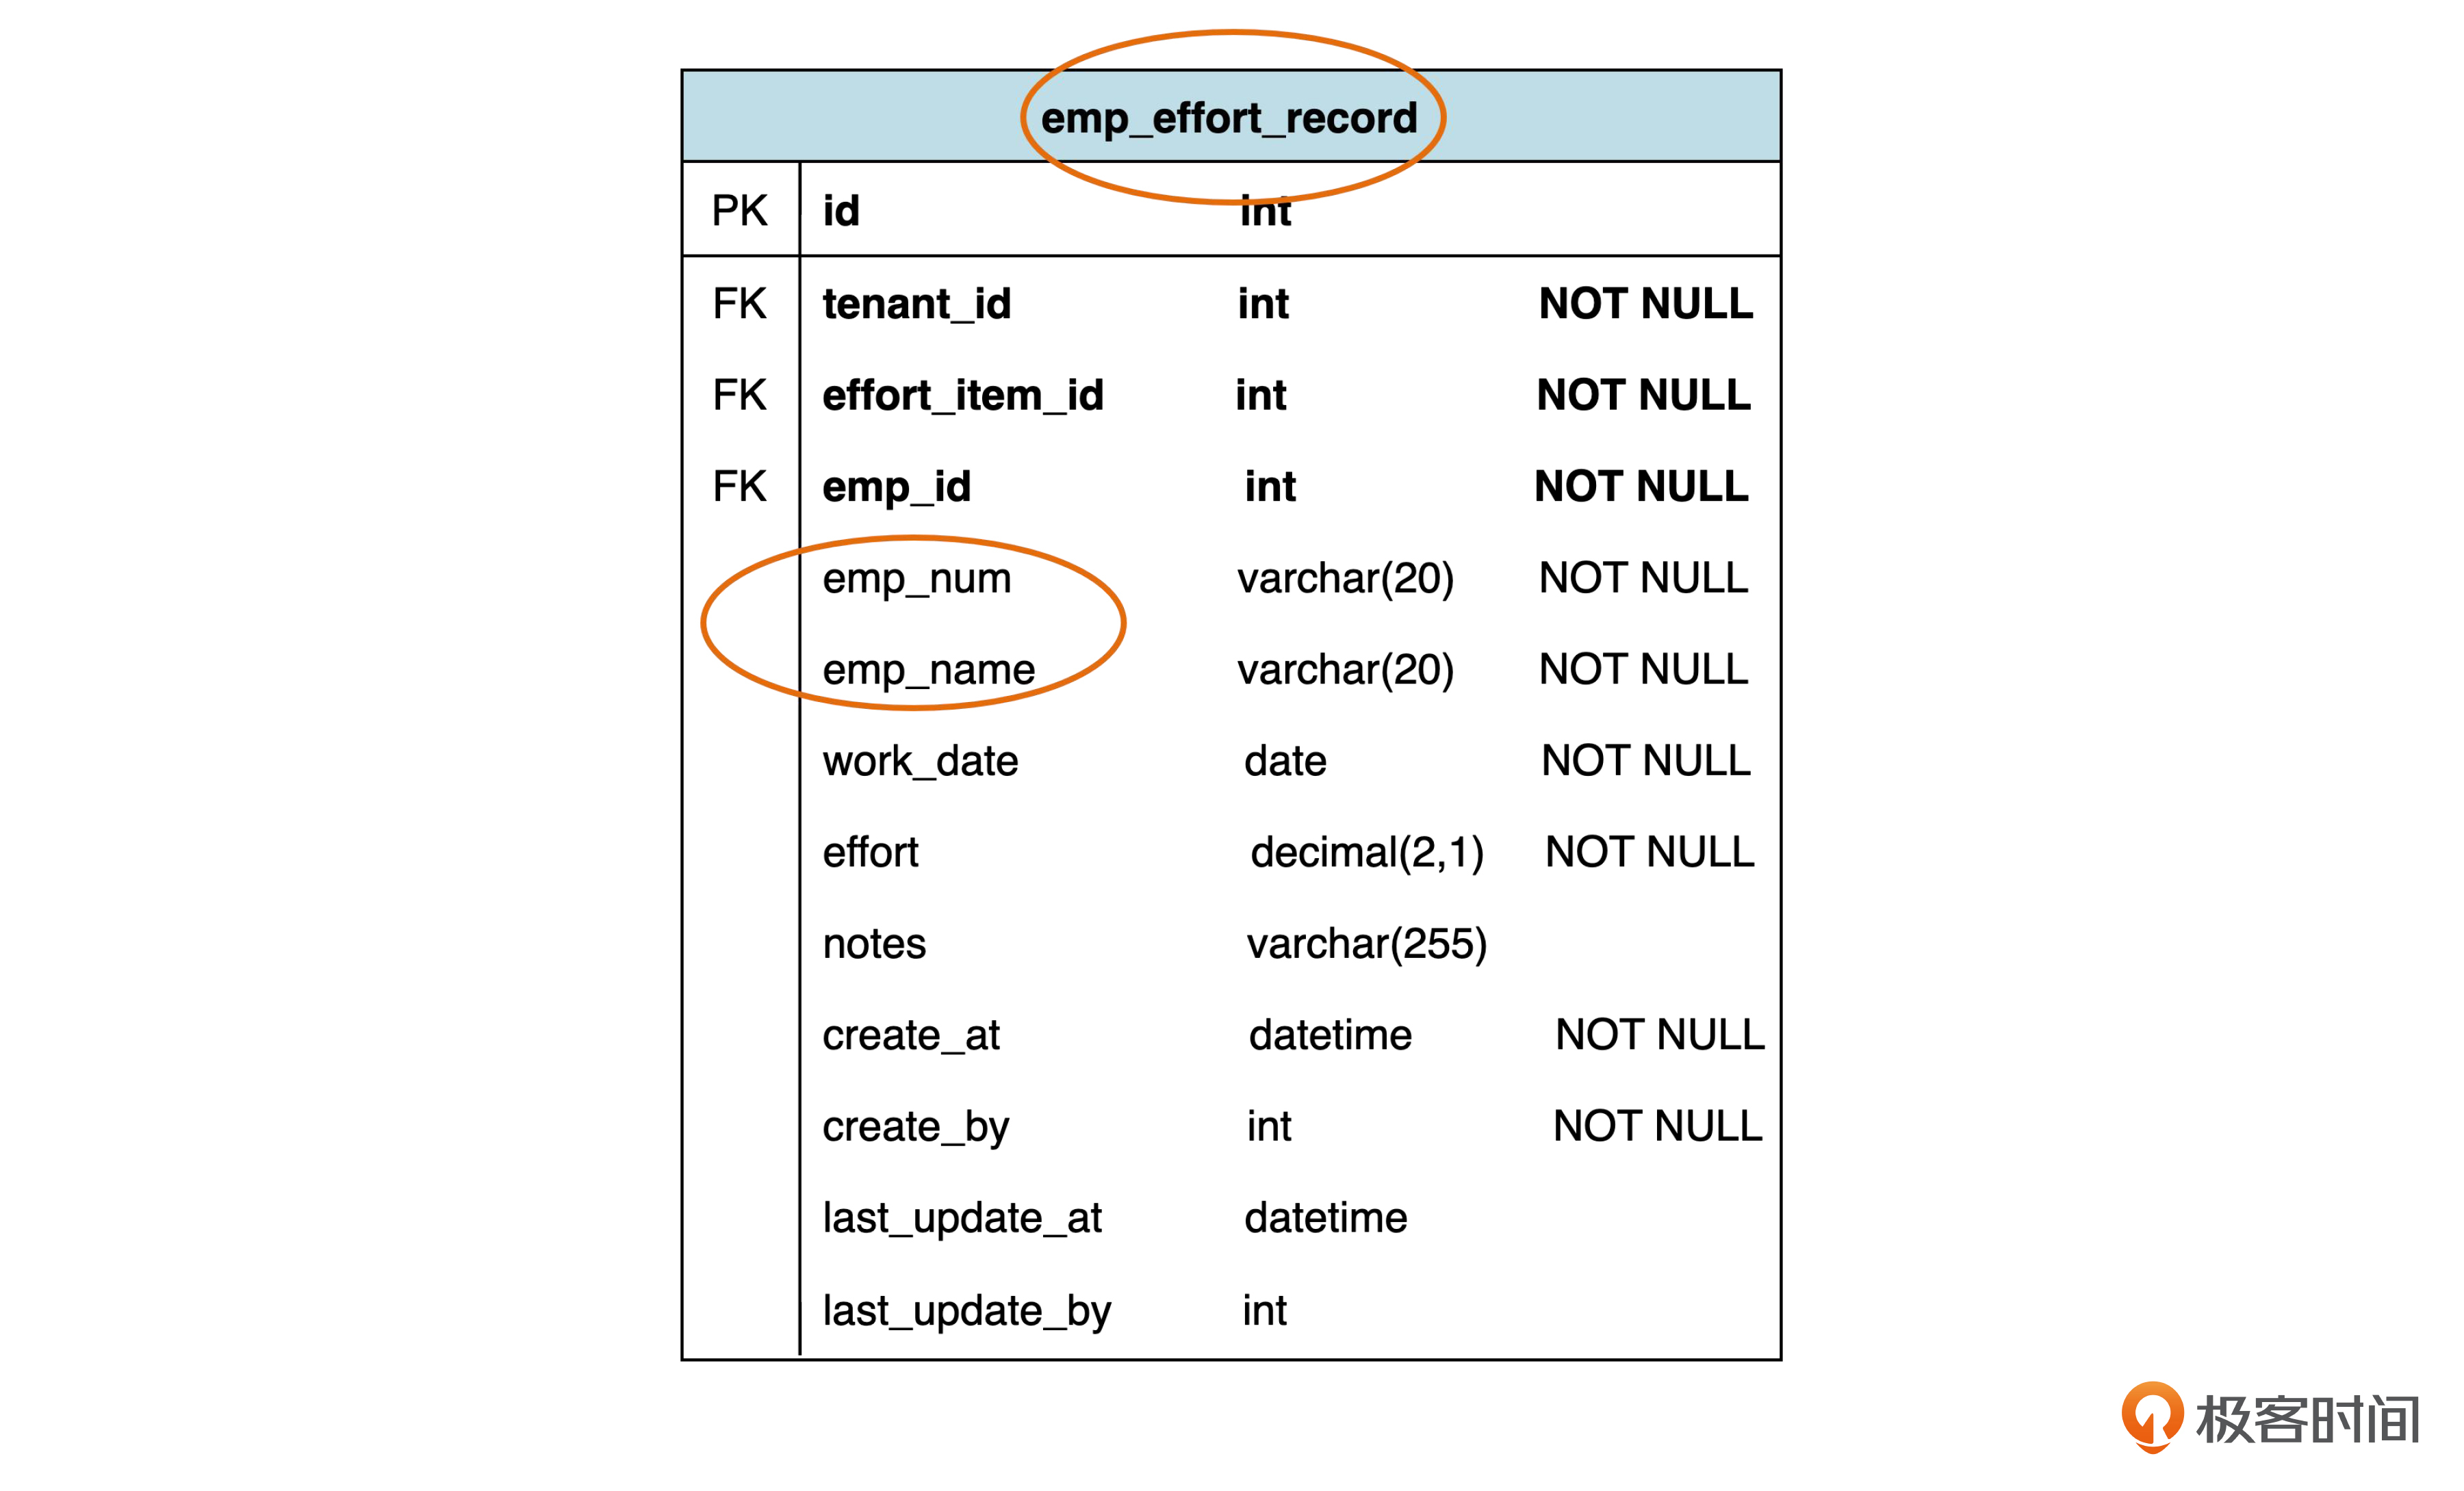
其实表设计的变化很简单,我们只是在表里增加了 emp_num(员工号)和 emp_name(员工姓名)两个字段。同时在原来的表名前面增加了 emp ,表示是员工表和工时记录表合并的表。
为什么说这样就“反规范化”了呢?
这是因为在这个表里,emp_num 和 emp_name 是可以由emp_id 唯一确定的。这种情况在数据库设计术语上叫做 “emp_num 和 emp_name 函数依赖于 emp_id”,简称 “emp_num 和 emp_name 依赖于 emp_id”。注意,这里说的数据库设计意义上的依赖,和 UML 里的依赖不是一个概念。
另一方面,emp_id 又是依赖于这个表的 id 的。这时就可以说,emp_num 和 emp_name 传递依赖于 id 。凡是一个表里有传递依赖关系的,这个表就违反了第三范式(3NF)。
至于第二范式是怎么回事,你有兴趣的话,找一本数据库设计的书看看就可以了。我这里只说一句,如果一个表里只有一个字段(例如 id)做主键,那么在原理上就是不可能违反第二范式的。
在命令模型里,一般是不主张违反范式的,这是因为违反范式必然造成数据冗余,数据冗余就会造成潜在的数据不一致风险。而在查询模型中,不仅允许,甚至是鼓励反规范化设计。这是因为,对于查询模型,反规范化的风险是可控的。就算数据发生了不一致,总可以从命令模型里按正确的逻辑重新生成一遍。
如果你不满足于仅仅在物理数据模型上表示出查询模型,还想在领域模型层面把命令模型和查询模型的关系表示得更清楚,可以把图画成这样。

在这个图里,工时记录和员工是原来领域模型里的实体,没有变化。而员工工时记录则是查询模型中的“查询实体”(我们姑且这么命名吧)。我们用自定义的<<query model>>衍型来表示这是一个查询模型里的查询实体。
员工工时记录中的数据是来源于工时记录和员工的,所以对这两个实体有依赖关系。另外,我们在依赖关系上加了<<trace>>。这是 UML 里的标准衍型,表示“追溯”的意思。这是因为,员工工时记录里的信息,总能追溯回工时记录和员工,从而知道数据的来源。
顺便说一句,我们原来说过领域模型和设计模型的区别,如果你愿意的话,领域模型里的一个实体和设计模型里的对应实体,也可以用 <<trace>> 依赖来关联起来,表示两者之间的来源关系。
我把这种图称为“查询模型图”,一般会单独画出来,只保留和查询模型有关的实体和关联。如果都画在领域模型图里,就太混乱了。当查询模型里的表比较多的时候,如果靠拍脑袋设计,就可能设计出混乱重复的表结构,最终导致设计失控。有了查询模型图,我们就可以用一种受控的方式进行反规范化的模型设计了。
数据库结构分离策略的好处是提高了性能。但这么做也有明显代价,包括后面三个方面。
1.增加了两种数据模型同步的复杂性和出错的可能性。
2.数据同步可能带来性能损失。
3.会占用额外的存储空间。
总结
好,这节课先讲到这,下面来总结一下。
今天我们学习了 CQRS (Command Query Responsibility Segregation),也就是“命令和查询职责分离”模式。
尽管通过 DDD 的领域模型完成增、删、改等功能是很适合的,但是通过领域模型来实现查询功能,常常是比较繁琐的,而且性能也不高。因此, CQRS 就成了 DDD 的有力补充。
根据 CQRS ,命令(也就是增、删、改功能)和查询功能的实现逻辑应该是不一样的。为了处理这种不一样的逻辑,我们今天讲了两种策略:代码结构分离和数据库结构分离。
为了实现数据库结构分离,我们也讨论了怎样进行反规范化设计,以及这种设计是怎样违反第三范式的,从而让你了解背后的所以然。
另外,我们还介绍了“查询模型图”,有了它,我们就可以在更高的层面,对查询模型进行系统化的设计。
思考题
最后给你留两道思考题。
1.今天课程中的需求其实做了简化,没有考虑“父子工时项”以及“不在本级报工时”的情况,如果考虑了这两种情况,甚至本级和下级子工时项都能报工时,那么 SQL 语句就不太好写了。这时候,你觉得可以用什么办法处理呢?
2.我们今天谈反规范化的时候,是另外建立了一套表。还有一种策略,是直接在原来为领域模型建的表上进行反规范化。你觉得这两种策略各自的利弊是什么?
好,今天的课程结束了,有什么问题欢迎你在评论区留言。下节课,我再带你了解实现 CQRS 的另外几种策略,敬请期待。